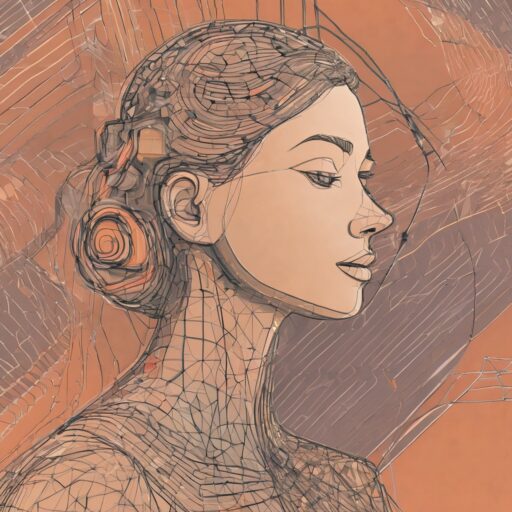
Tippen Sie einen Prompt in ein Bildmodell, geben Sie die Kontrolle in dem Moment ab, in dem Sie Enter drücken. Sie wollten eine Figur, die nach links blickt; sie blickt nach rechts. Sie wollten den Horizont tief; das Modell schiebt ihn auf zwei Drittel der Höhe. Worte sind ein grobes Werkzeug, um Form, Haltung und Platzierung zu beschreiben. ControlNet gibt diese Entscheidungen an die Künstlerin und den Künstler zurück.
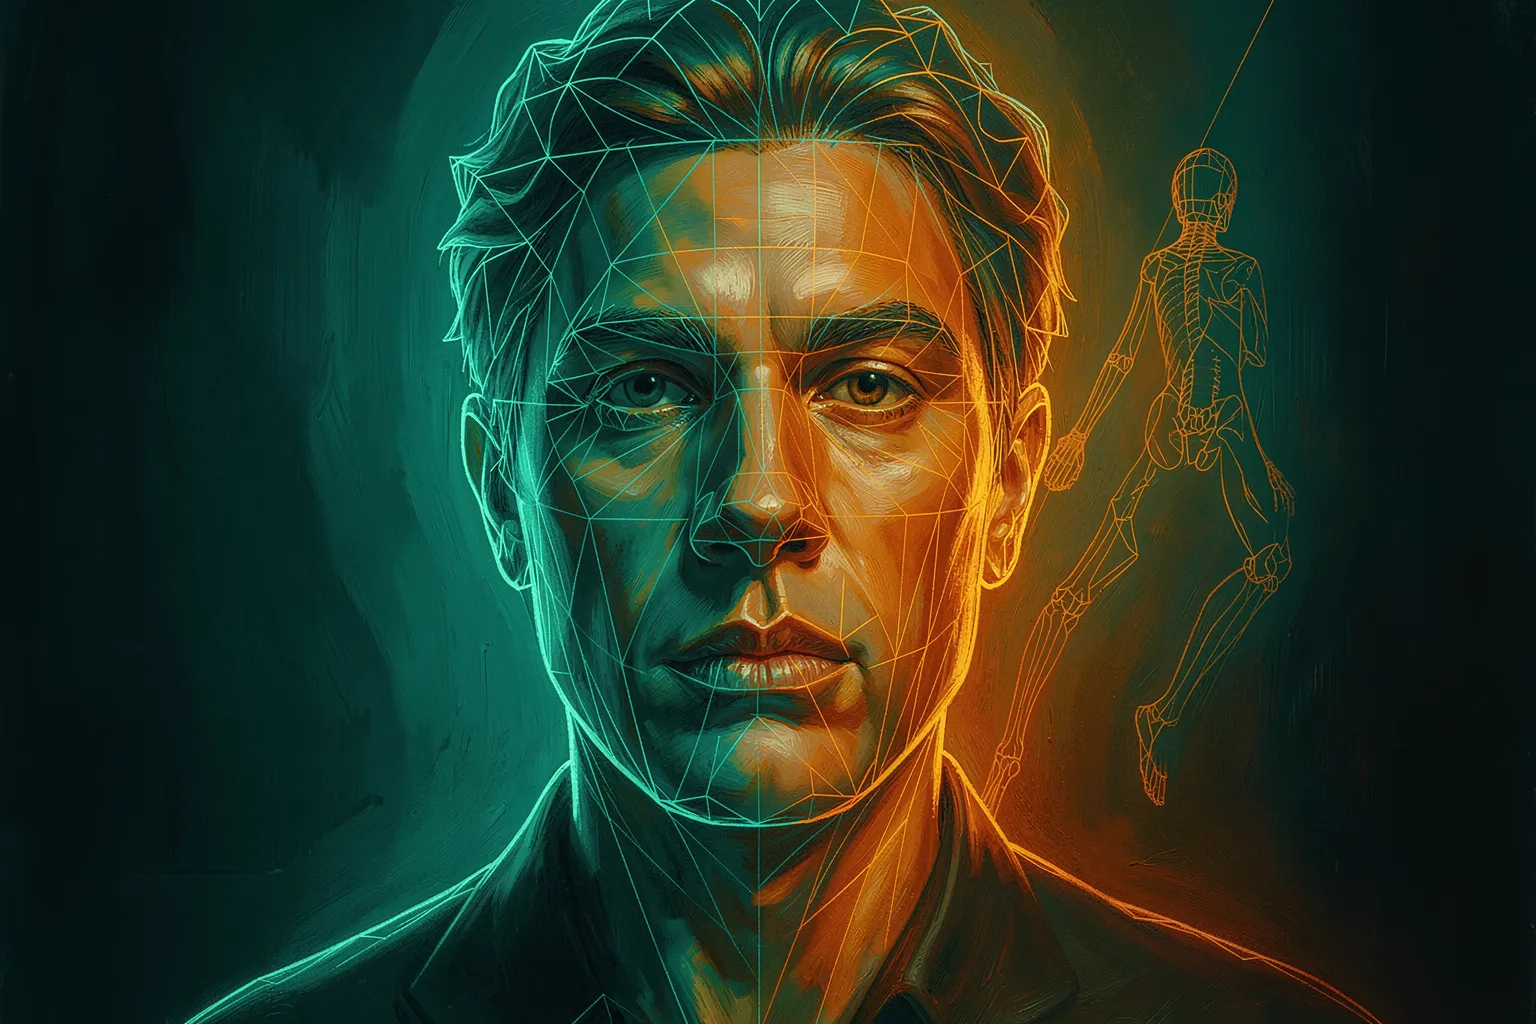
Es funktioniert, indem es dem Modell neben dem Text eine zweite Eingabe mitgibt: eine strukturelle Karte. Eine Kantenzeichnung, ein Tiefenfeld, ein Strichmännchen-Skelett, eine Kritzelei. Das Modell erfindet Farben, Texturen und Stil weiterhin aus Ihren Worten, aber es muss nun die Geometrie respektieren, die Sie ihm vorgeben. Der Prompt sagt, was. Die Steuerkarte sagt, wo.
Woher die Methode stammt
Lvmin Zhang veröffentlichte ControlNet im Februar 2023, aus seiner Arbeit in Stanford mit Maneesh Agrawala. Die Veröffentlichung benannte das Problem unmissverständlich: Diffusionsmodelle waren großartig im Generieren und miserabel im Gehorchen. Der Kniff war architektonisch. Statt ein riesiges Modell von Grund auf neu zu trainieren, klonte Zhang den Encoder eines bestehenden Modells, fror die ursprünglichen Gewichte ein und trainierte nur die Kopie an gepaarten Daten — etwa einem Bild und seiner Kantenkarte. Die beiden Hälften verbinden sich über das, was er Zero-Convolution-Schichten nannte: Sie beginnen bei null und fahren im Training langsam hoch, sodass das Basismodell nie zerstört wird, während es die neue Konditionierung lernt.
Dieses Design erklärt, warum sich ControlNet so schnell verbreitete. Sie brauchten kein Rechenzentrum. Menschen trainierten brauchbare Steuermodelle an einem Wochenende auf einer einzigen Consumer-GPU, und innerhalb weniger Monate gab es Dutzende — eines für Kanten, eines für die menschliche Haltung, eines für Tiefe, eines für Segmentierungskarten, eines, das die Kritzelei eines Kindes in eine fertige Szene verwandelt.
Die Karten, zu denen Künstler wirklich greifen
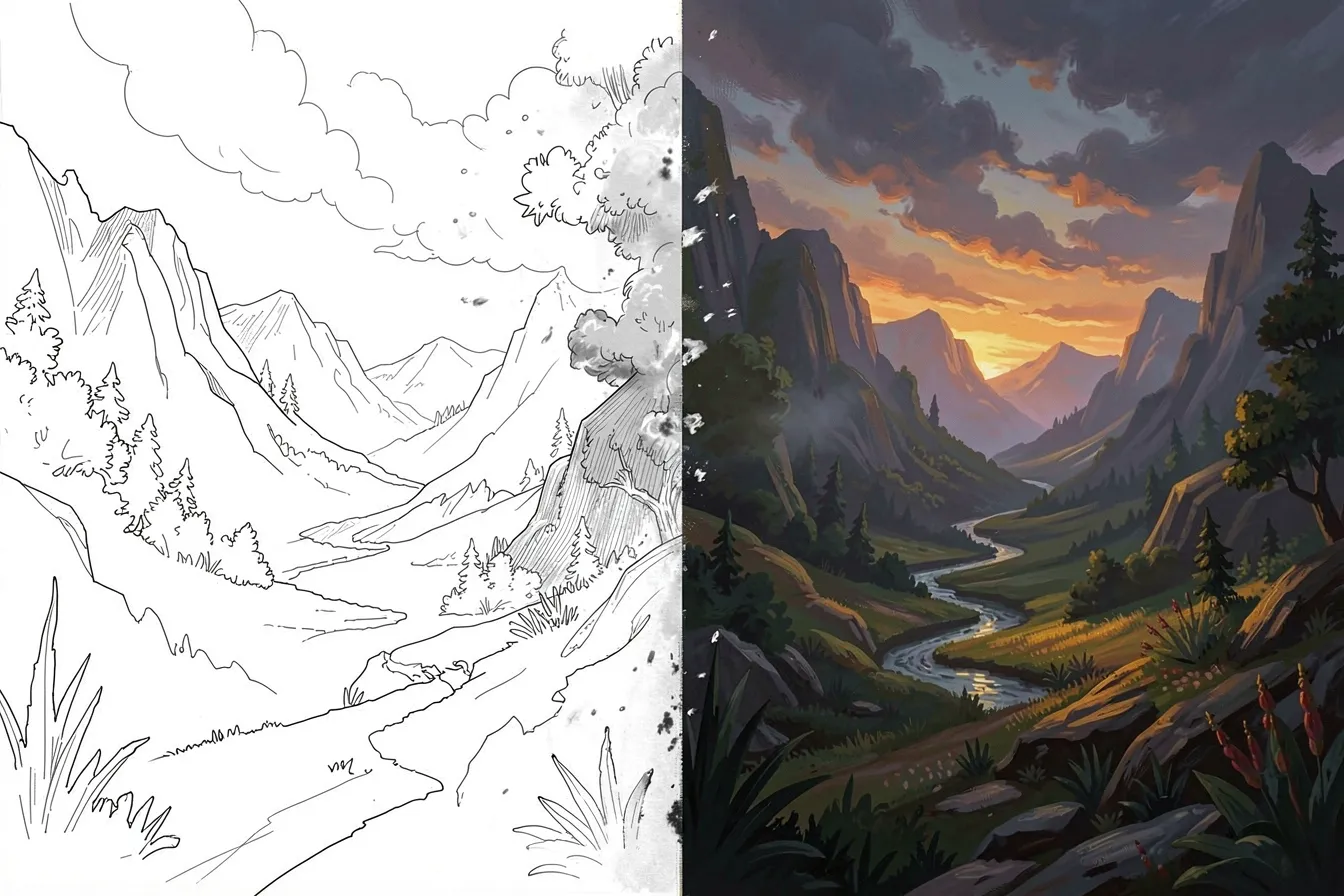
Eine Handvoll erledigt den Großteil der Arbeit. Canny legt einen klassischen Kantenfilter über ein Referenzbild und behält die harten Umrisse — gut, wenn Sie eine Komposition exakt bewahren, aber in einem neuen Stil neu malen wollen. Depth liest Nah und Fern als Graustufenverlauf, womit Sie die räumliche Anordnung eines Raums oder einer Landschaft festhalten und alles andere austauschen können. OpenPose zieht ein Skelett aus dem Foto einer Person und verwendet nur die Haltung weiter, sodass Sie eine völlig erfundene Figur in genau die Stellung bringen, die Sie wollen. Scribble ist die lockerste Variante: Zeichnen Sie eine grobe Form, und das Modell behandelt Ihre Linien als Vorschlag statt als Käfig.
Der praktische Unterschied zählt. Canny ist streng und wehrt sich, wenn Ihr Prompt etwas will, das die Umrisse verbieten. Depth ist nachsichtig beim Detail, aber unnachgiebig beim Aufbau. Pose ignoriert alles außer dem Körper. Zu wissen, welche Karte welche Eigenschaft einschränkt, ist der Großteil des Könnens.
Was sich an der Arbeit änderte
Vor ControlNet hieß ein Diffusionsmodell zu steuern: würfeln und neu würfeln. Sie generierten vierzig Bilder in der Hoffnung, dass eines die Komposition traf, und flickten den Rest per Inpainting zurecht. Das war langsam und fühlte sich nach Glücksspiel an. ControlNet machte daraus etwas, das dem Zeichnen näherkommt. Skizzieren Sie den Aufbau, geben Sie ihn hinein, und das Modell füllt Ihre Struktur, statt seine eigene zu improvisieren.
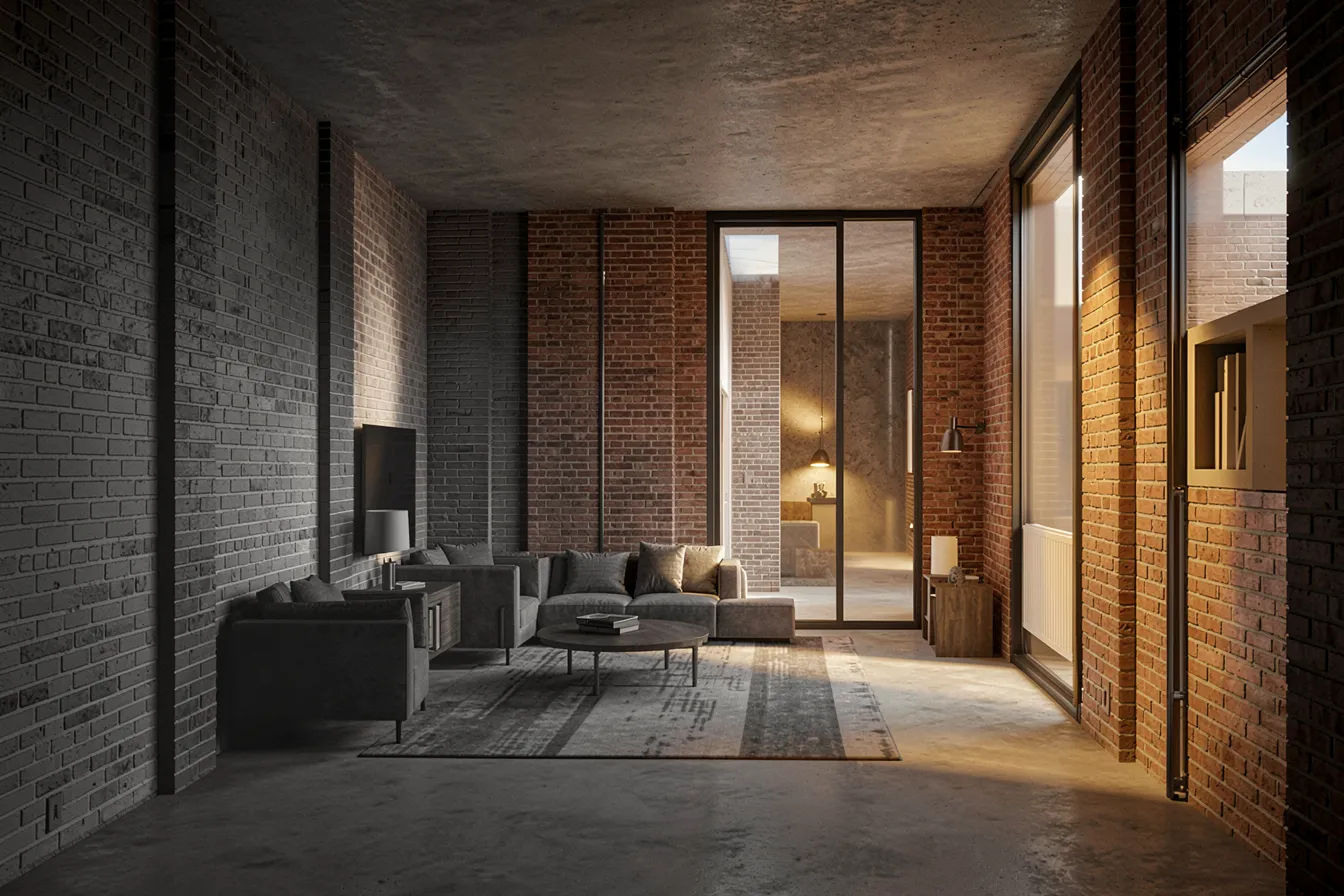
Illustratoren halten damit eine Figur über eine Panel-Folge hinweg konsistent — dieselbe Haltungsreferenz, andere Prompts, und die Figur bleibt an ihrem Platz. Konzeptkünstler fotografieren eine grobe Tonskizze, ziehen eine Tiefenkarte davon ab und rendern an einem Nachmittag fünfzig Materialvarianten auf genau dieser Form. Architekturvisualisierer zeichnen eine Massenstudie nach und lassen das Modell sie in Backstein, Glas oder Beton kleiden, ohne eine einzige Wand zu verschieben. Der rote Faden: Der Mensch besitzt die Komposition, die Maschine besitzt die Oberfläche.
Die Spannung, die es einbrachte
Hier wird es interessant, und ein wenig unbequem. ControlNet ließ KI-Bilderzeugung urheberischer wirken — Sie zeichnen wieder, statt nur zu tippen — aber es machte es auch leichter, die Komposition eines anderen zu waschen. Geben Sie ein berühmtes Foto als Canny-Referenz hinein, und Sie reproduzieren dessen exakten Bildausschnitt in einem anderen Stil, was rechtlich wie ethisch in einer trüben Zone liegt. Das Werkzeug kümmert sich nicht darum, ob die Kantenkarte aus Ihrer eigenen Skizze oder aus einer urheberrechtlich geschützten Aufnahme stammt. Das ist eine Entscheidung, die die Künstlerin oder der Künstler trifft, und manche treffen sie schlecht.
Es gibt auch einen handwerklichen Preis. Übertreiben Sie die Konditionierungsstärke, sieht Ihr Ergebnis abgepaust aus — steif, leblos, offensichtlich kopiert. Setzen Sie sie zu niedrig, tut die Steuerkarte nichts. Die gute Arbeit lebt in der Mitte, wo Sie dem Modell einen Rahmen geben und ihm dennoch Raum lassen, Sie zu überraschen. Viel frühes ControlNet-Material scheiterte genau daran: technisch gehorsam, kreativ tot.
Wo es heute steht
Neuere Basismodelle haben einen Teil dessen aufgenommen, was ControlNet leistete — die besseren folgen räumlichen Anweisungen in einfacher Sprache weit zuverlässiger als die Generation von 2023. Doch die strukturelle Konditionierung ist nicht verschwunden, denn ein Satz kann eine Haltung nicht so festlegen wie ein Skelett, und einen Aufbau nicht so wie eine Tiefenkarte. Die Nachkommen kamen weiter: Tile-Modelle fürs Hochskalieren, Referenzmodelle, die Stil von einem Bild auf ein anderes übertragen, Steueradapter für die neuesten Architekturen.
Der tiefere Punkt ist, dass ControlNet neu definierte, was diese Werkzeuge sind. Ein reines Text-zu-Bild-Modell ist ein Spielautomat mit Vokabular. Fügen Sie strukturelle Steuerung hinzu, wird es zu einem Instrument, das Sie spielen — eines, bei dem Ihre Hand an der Komposition das ist, was das Ergebnis zu Ihrem macht und nicht zu dem des Modells. Für alle, denen Urheberschaft in der KI-Kunst wichtig ist, ist dieser Wechsel vom Beschreiben zum Dirigieren der eigentliche Kern.
Möchten Sie strukturelle Steuerung in verschiedenen Stilen in Aktion sehen? Entdecken Sie mehr auf ai-art-designer.de und steuern Sie eine eigene Komposition.
Bilder: AI-Designed
Dieser Beitrag ist auch verfügbar auf:
 Deutsch